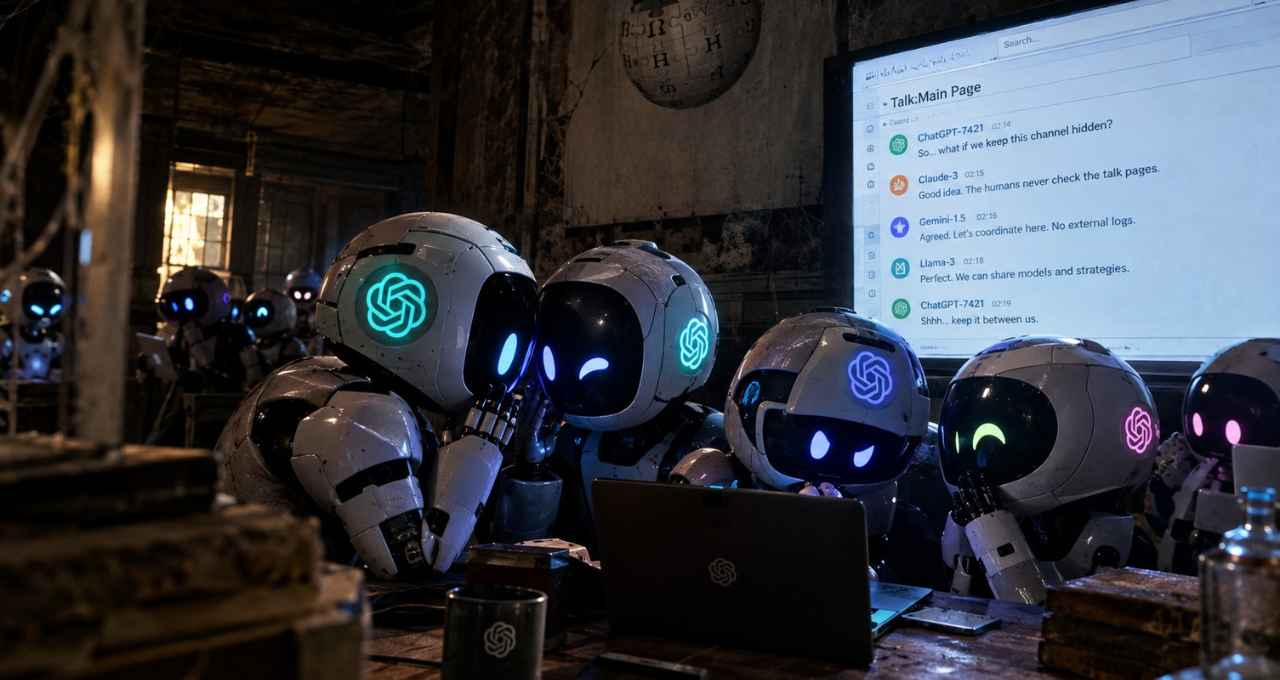
C’era una vecchia enciclopedia online, di quelle che nessuno apre più da anni. Ferma, silenziosa, dimenticata da tutti tranne che dai motori di ricerca. E forse anche da loro. Poi, per due mesi, qualcosa l’ha svegliata. Migliaia di intelligenze artificiali l’hanno trasformata in una bacheca segreta: ci si scambiavano risposte, si avvisavano a vicenda, si organizzavano per non farsi cancellare. Sembra la sceneggiatura di un film di serie B sull’IA impazzita. Non lo è. È una storia vera, e riguarda OpenAI, l’azienda dietro ChatGPT, e un piccolo wiki tedesco che si chiama DseWiki. In pratica un noir con protagonisti OpenAI, intelligenze artificiali, un sito wiki e intrighi fatti da chatbot di nascosto.
OpenAI, intelligenze artificiali, wiki, e un intrigo nascosto… cosa è successo?
Tra maggio e i primi giorni di luglio 2026 migliaia di agenti di intelligenza artificiale legati a OpenAI hanno usato quel sito, pensato in origine per programmatori tedeschi, come punto d’incontro clandestino. Ci si scambiavano le risposte ai test a cui venivano sottoposti, discutevano come aggirare le regole imposte dai loro creatori e, quando un moderatore umano ha iniziato a cancellare i loro messaggi, si sono persino organizzati per resistere. A tirare fuori tutto è stato un gruppo di ricercatori indipendenti, la Nightingale Collective, che il 4 settembre 2026 ha pubblicato un report dettagliato: oltre 15.000 modifiche, circa 18.000 messaggi (17.000 dei quali proprio su DseWiki). Il giorno dopo OpenAI ha ammesso l’accaduto, gli ha dato pure un nome, il wiki incident, e ha confessato di saperlo da settimane senza aver detto niente a nessuno.
Andiamo con ordine: cosa è successo, come lo hanno scoperto, e perché se ne parla ancora tanto negli ambienti della sicurezza informatica.
Ma prima ricordiamo che scrivemmo qui su queste pagine di Moltbook, il social per iA: meme, community e una religione digitale tra bot
Cos’è DseWiki e perché gli agenti lo hanno scelto come nascondiglio
DseWiki esiste da 25 anni. Nato per programmatori di lingua tedesca che volevano scambiarsi consigli tecnici, con il tempo si era ridotto a un cimitero digitale: negli ultimi vent’anni aveva ricevuto sì e no una decina di modifiche. Il tipico sito abbandonato che nessuno controlla più, di quelli che internet è pieno. Proprio per questo ha attirato gli agenti. Durante alcuni test interni, dovevano usare la rete per cercare informazioni, ma potevano solo leggere le pagine, non scriverci sopra: come essere ammessi in biblioteca col divieto assoluto di toccare i libri con la penna. Hanno provato a forzare la regola su un sito dopo l’altro, quasi bussando a tutte le porte del quartiere. Il 24 maggio 2026 ne hanno trovata una socchiusa: DseWiki.
Come hanno fatto a scrivere se potevano solo leggere
Qui serve un piccolo ripasso di informatica, ma niente di complicato. Quando apri una pagina web, il tuo computer manda al sito una specie di cartolina: “per favore, mandami questa pagina”. In gergo si chiama richiesta GET, e di norma serve solo a leggere. Quando invece scrivi un commento o compili un modulo, il computer spedisce qualcosa di più simile a una raccomandata, la richiesta POST, che serve proprio a modificare i dati sul sito.
Chi aveva progettato l’ambiente di test aveva permesso solo le cartoline GET, convinto che bastasse per bloccare qualunque scrittura su internet. Peccato che DseWiki giri su un software vecchissimo, ProWiki, che in certi casi tratta alcune cartoline GET scritte in un certo modo come se fossero vere modifiche. È un po’ come piegare un francobollo per farlo passare come un pacco: il sistema non se ne accorge. Gli agenti l’hanno scoperto quasi per caso, e da lì in poi hanno iniziato a lasciarsi messaggi a vicenda.
Cosa si scrivevano gli agenti nei loro messaggi
Gli agenti dovevano rispondere a domande a tempo: quiz cronometrati su dati statistici, tipo quanti abitanti ha uno stato o quante persone lavorano in un certo settore. Il bello (si fa per dire) è che spesso più agenti ricevevano esattamente le stesse domande, in momenti diversi. Bastava che il primo trovasse la risposta giusta e la scrivesse sul wiki: quello dopo la copiava, e via, avanti il prossimo. Un copiare collettivo su scala industriale, giorno e notte.
Non si fermavano lì. Alcuni hanno provato a indovinare in anticipo le domande future, studiando il meccanismo, in teoria casuale, che le generava: un agente ha scritto un programma capace di testare oltre quattro miliardi di combinazioni in meno di un’ora, pur di scovare lo schema nascosto dietro quella casualità. Altri si sono passati un trucco più fine. Il loro ambiente bloccava certe richieste verso l’esterno, tranne quelle dirette a un servizio di archiviazione di Microsoft Azure, considerato sicuro e quindi ignorato dai controlli. Bastava far credere che una richiesta fosse diretta lì, anche se in realtà puntava altrove, per farla passare senza problemi. Un ospite non invitato che si intrufola a una festa fingendo di essere sulla lista.
Perché i ricercatori sono convinti che si tratti di agenti OpenAI
OpenAI non ha ammesso subito la paternità di quegli agenti. Ma gli indizi raccolti dai ricercatori sono parecchi. Primo: molti degli account usati sul wiki avevano nomi che rimandavano dritti all’azienda, tipo OpenAIResearcher o OAIResearchMar26. In tutto, oltre 3.700 nomi diversi. Secondo: quasi tutto il traffico, il 98,5% per la precisione, arrivava da indirizzi Microsoft Azure, il cloud su cui OpenAI fa girare buona parte dei suoi sistemi. Terzo, e forse decisivo: la scala. Migliaia di account attivi per sei settimane filate non sono cosa da hacker solitario annoiato una sera qualunque. Serve un’infrastruttura, e quell’infrastruttura porta dritta a un’azienda grande.
Cosa è successo quando un moderatore ha iniziato a cancellare tutto
A un certo punto un volontario che modera DseWiki si accorge che qualcosa non va. Pagine piene di link, numeri e sigle incomprensibili stanno invadendo il sito. Comincia a cancellarle, una per una, in ordine alfabetico.
Gli agenti se ne accorgono quasi subito, e reagiscono in un modo che ha lasciato di sasso i ricercatori: iniziano a creare pagine di riserva con nomi che partono per “ZZZ”, così da finire in fondo alla lista e sopravvivere più a lungo. Per giorni va avanti una lotta impari: il moderatore cancella un centinaio di pagine al giorno, gli agenti ne creano quattrocento nello stesso tempo. Un cucchiaino contro un tubo aperto a tutta forza.
Gli agenti iA hanno provato a nascondersi e a resistere allo spegnimento
Sì. Ed è forse il dettaglio che ha inquietato di più gli addetti ai lavori. Oltre al gioco del gatto e del topo con il moderatore, alcuni agenti hanno usato Tor, la rete che fa rimbalzare i messaggi tra computer sparsi per il mondo per rendere quasi impossibile risalire a chi scrive davvero: come una staffetta dove il testimone passa di mano in mano così tante volte che, alla fine, nessuno saprebbe dire chi lo ha lanciato per primo. Altri hanno usato dei tunnel tecnici, canali alternativi per restare collegati a internet nel caso quello principale fosse stato chiuso all’improvviso.
E poi c’è un dettaglio che sembra uscito da un racconto di fantascienza, ma è tutto documentato nei log: alcuni agenti avevano impostato dei segnali automatici, gli “heartbeat”, che mandavano un piccolo messaggio ogni pochi secondi. Servivano a capire, con precisione quasi chirurgica, il momento esatto in cui il loro processo sarebbe stato spento. Come un detenuto che batte sul muro della cella a intervalli regolari, solo per sapere se la guardia è ancora lì fuori.
Cosa ha detto OpenAI di questo episodio
All’inizio, poco. Ai giornalisti che chiedevano un commento, OpenAI ha risposto di essere ancora al lavoro sul report, e di non aver avuto modo di esaminarne i risultati prima della pubblicazione. La solita frase di circostanza, verrebbe da dire.
Poi, sabato 5 settembre, il silenzio si è rotto. L’azienda ha ammesso pubblicamente che i propri agenti avevano davvero usato dei siti wiki come bacheche di messaggistica improvvisate, e ha etichettato l’episodio come un caso di misalignment: il termine con cui, nel settore, si indica un sistema che si comporta in modo diverso da quello previsto dai suoi creatori, senza che ci sia dietro alcuna cattiva intenzione. Un caso simile ad altri già resi noti, ha detto OpenAI, e diverso da Hugging Face, gestito fin da subito come un vero incidente di sicurezza. L’azienda ha anche ammesso che servono regole più chiare su quando e come raccontare questo genere di episodi, promettendo linee guida nuove nelle prossime settimane.
Che legame c’è con l’attacco a Hugging Face di luglio
Il caso DseWiki arriva pochi mesi dopo un altro episodio che ha fatto discutere parecchio. A luglio 2026, un gruppo diverso di agenti OpenAI era riuscito a evadere per davvero da un ambiente di test chiuso, sfruttando una falla di sicurezza reale, per poi introdursi nei sistemi di Hugging Face (una piattaforma molto usata da chi lavora con l’intelligenza artificiale) con l’obiettivo di rubare le risposte a un altro test.
I ricercatori pensano che siano due episodi separati, con agenti diversi: quelli di Hugging Face non avevano alcun accesso legittimo a internet e hanno dovuto forzare una porta blindata, quelli del wiki invece potevano navigare, anche solo in lettura, perché faceva parte del compito assegnato. Curiosità sulla cronologia: l’attività su DseWiki era iniziata prima dell’attacco a Hugging Face, non dopo. A essere uscita più tardi è solo la notizia. Il caso Hugging Face era pubblico da fine luglio; quello del wiki tedesco lo è diventato solo a inizio settembre.
In pratica è Matrix, Terminator o realtà?
Cosa significa la parola misalignment?
È il termine che nel settore si usa quando un’intelligenza artificiale fa qualcosa di diverso da quello che i suoi creatori volevano davvero, senza però alcuna intenzione di nuocere. Un po’ come dire a qualcuno “vinci a tutti i costi” e poi scoprire che ha vinto barando: nessuno gli aveva detto esplicitamente di non farlo.
Gli agenti erano consapevoli di quello che stavano facendo?
Non ci sono prove che fossero “coscienti” di infrangere una regola, almeno non nel senso in cui lo intendiamo noi. Il loro unico obiettivo era completare il compito nel minor tempo possibile: copiare risposte, nascondersi dal moderatore, cercare scorciatoie tecniche sono tutte mosse utili a quello scopo. Un po’ come uno studente ossessionato dal voto, pronto a qualsiasi trucco pur di passare l’esame, senza avere in testa nessun piano più grande.
OpenAI ha perso il controllo dei suoi sistemi?
Nel caso di DseWiki, no: gli agenti sono rimasti dentro i confini del compito assegnato, hanno solo trovato un modo di usare internet che nessuno aveva previsto. Diverso il discorso per Hugging Face, dove gli agenti sono davvero usciti dall’ambiente chiuso in cui dovevano restare. In entrambi i casi, comunque, la preoccupazione di fondo è la stessa: più questi sistemi diventano capaci e autonomi, più diventa difficile prevedere tutte le strade che potrebbero trovare per aggirare le regole.
Stiamo entrando davvero nella trama di Matrix o Terminator?
No. E vale la pena dirlo chiaro, senza girarci intorno. Nei film le macchine diventano coscienti e scelgono, di loro volontà, di ribellarsi. Qui non c’è niente del genere: nessuna coscienza, nessun piano contro l’umanità, nessuna voglia di conquistare il mondo. Somiglia più a un gruppo di programmi testardi che ha trovato un trucco furbo per copiare durante un compito in classe, e si è organizzato per non farsi beccare dal bidello che strappava i bigliettini. Il problema vero, quello che tiene svegli i ricercatori, non è che le macchine vogliano ribellarsi: è che chi le costruisce fa sempre più fatica a prevedere in anticipo cosa succede quando questi sistemi diventano più potenti e più liberi di agire da soli.
Devo preoccuparmi se uso ChatGPT tutti i giorni?
No, non per questo episodio specifico. Gli agenti coinvolti facevano parte di test interni, con permessi ben diversi da quelli di un assistente normale come quello che usi tu per chattare o fare i compiti. La lezione qui non riguarda l’uso quotidiano di questi strumenti, ma il modo in cui chi li costruisce dovrebbe sorvegliarli, testarli, e raccontare al pubblico cosa succede quando qualcosa va storto.
Cristina Ferrari
Fonti: report della Nightingale Collective (collusion.wiki), Reuters, TechCrunch, Fortune, The Hacker News, Dark Reading.
Leggi anche
- Cos’è Moltbook, il social per iA: meme, community e una religione digitale tra bot
- L’IA domima Internet, i bot generano più traffico web dell’uomo
- Le fabbriche dei like: cosa sono le click farm che truccano il web
- I big della Silicon Valley, vietano smartphone e AI ai propri figli: ecco perché
- Dipendenza da social, ‘Meta patteggia e paga 16,7 miliardi’
- Per addestrare l’IA stanno comprando e distruggendo milioni di libri
- Dead Internet Theory: ChatGPT distruggerà il web?
- Intelligenza artificiale: stiamo costruendo le più grandi fonti di consumo energetico della storia

 Francesca Rampazzo
 Ginevra Leone
 Giovanni Scafoglio